From AI Learning OS to a Personal AI Operating Layer
一个月的公开构建日志:从知识沉淀,到项目上下文与日常执行。以下是我从 7 月 25 日最初只能跑通知识沉淀,到 8 月开始接入项目上下文与日常执行这一阶段,真实的使用和迭代记录。部分链路已经跑通并进入日常使用,部分仍在设计和验证。它不是一套完成的方法论,而是一份 build-in-public 的演进日志。
这一切的起点,是一次被迫的迁移。我原本重度依赖 Claude Code,直到账号被封,工作流突然断了。匆忙转向别处时,我借 Hermes 的多 Agent 能力把流程重新搭了起来。但工具迁移只是导火索——真正把我逼向这套系统的,是同时跟进的项目越来越多,多到我自己都记不住某个任务到底跑在哪、卡在哪。而那时我本就在实践 Karpathy 的 second brain:它帮我存,却没帮我「每天该看什么」。于是很自然地,我顺着「怎么让已有知识和新工作流不被冲散」这个问题,一边用一边往前推。它不是被设计出来的架构,而是被真实麻烦一点点逼出来的。
它并不是搭在某一个 AI 工具里的完整系统。Hermes 是迁移后重要的 Agent 执行入口之一,Project Wiki、Memory、自动化任务和我自己做的 Work Board 分散运行在不同工具里;我真正想补的是它们之间那层连续的 Context。
这也是它为什么开始从一个 AI Learning OS,向更广义的 Personal AI Operating Layer 演化。
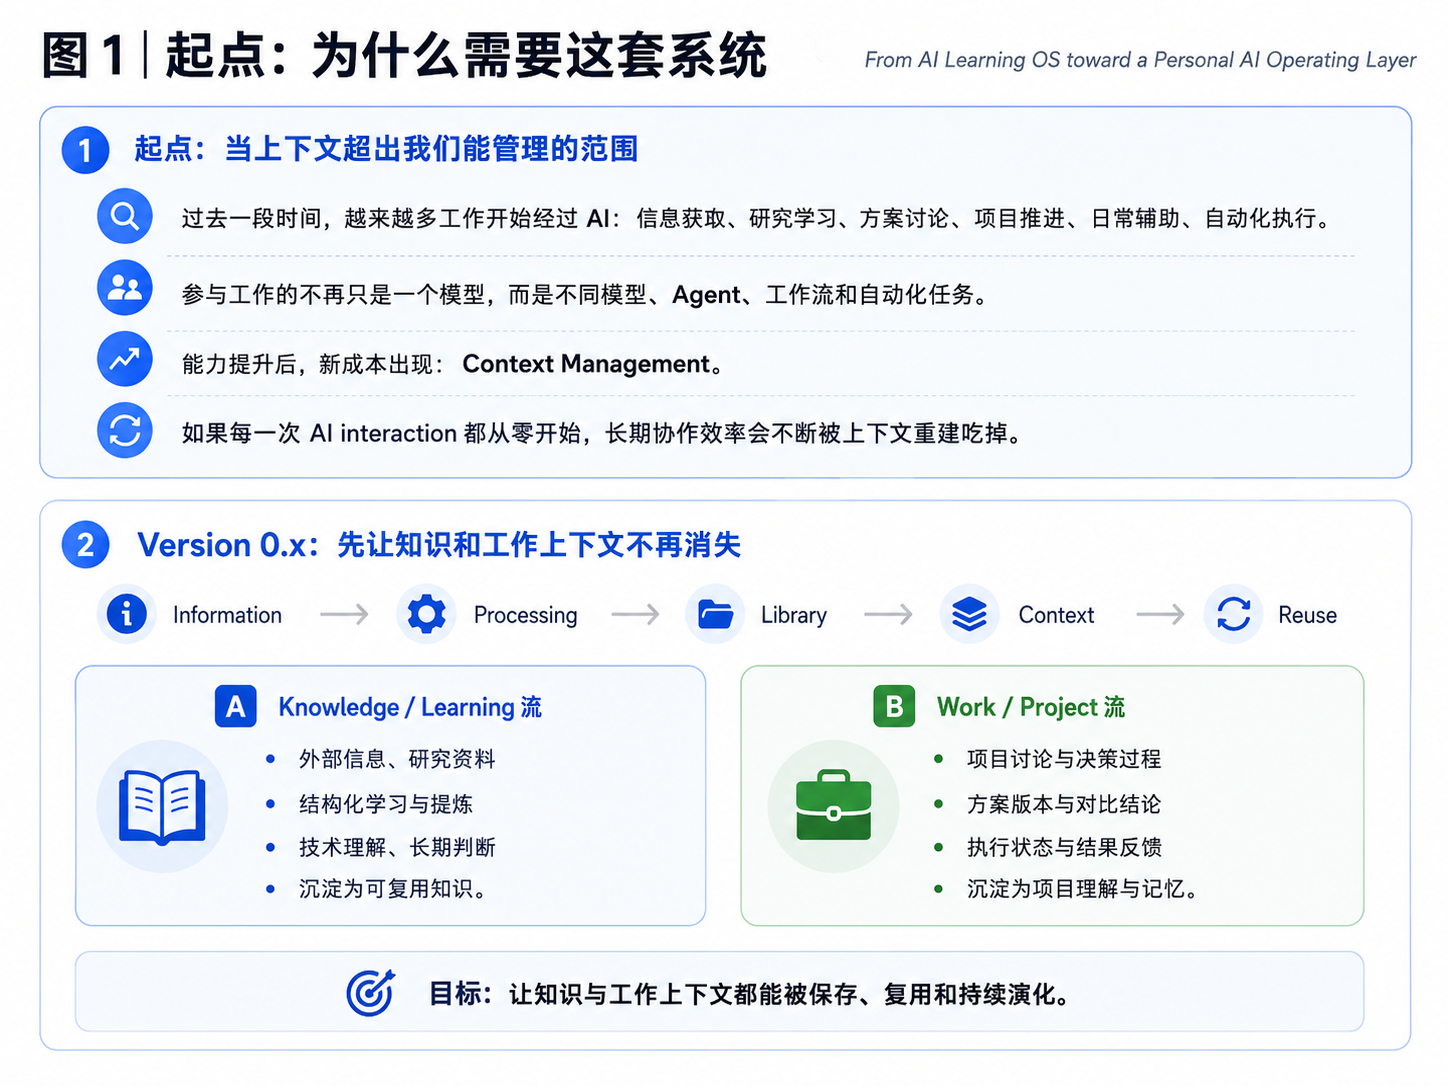
1. 起点:AI 能力提升以后,Context Management 反而变成了新的成本
账号被封之后,我重新搭起的工作流里,越来越多环节开始经过 AI:
- 外部信息获取与研究
- 长内容学习与理解
- 项目讨论与判断
- 方案与产出迭代
- 日常任务辅助
- 自动化的信息加工与执行
与此同时,参与工作的也不再只是一个模型,而是不同模型、Agent、工作流和自动化任务。
能力确实提升了,但一个新的成本随之出现:Context Management。
每天都会产生大量信息、判断、决策过程和中间产物。它们可能存在于一次 Chat、一份文件、一页笔记、某个 Agent 的上下文,或者某次自动化结果里,却彼此不知道对方的存在。
2. Version 0.x:先让「知识和工作上下文」不再消失
最初,我先从最熟悉的一条链路开始:
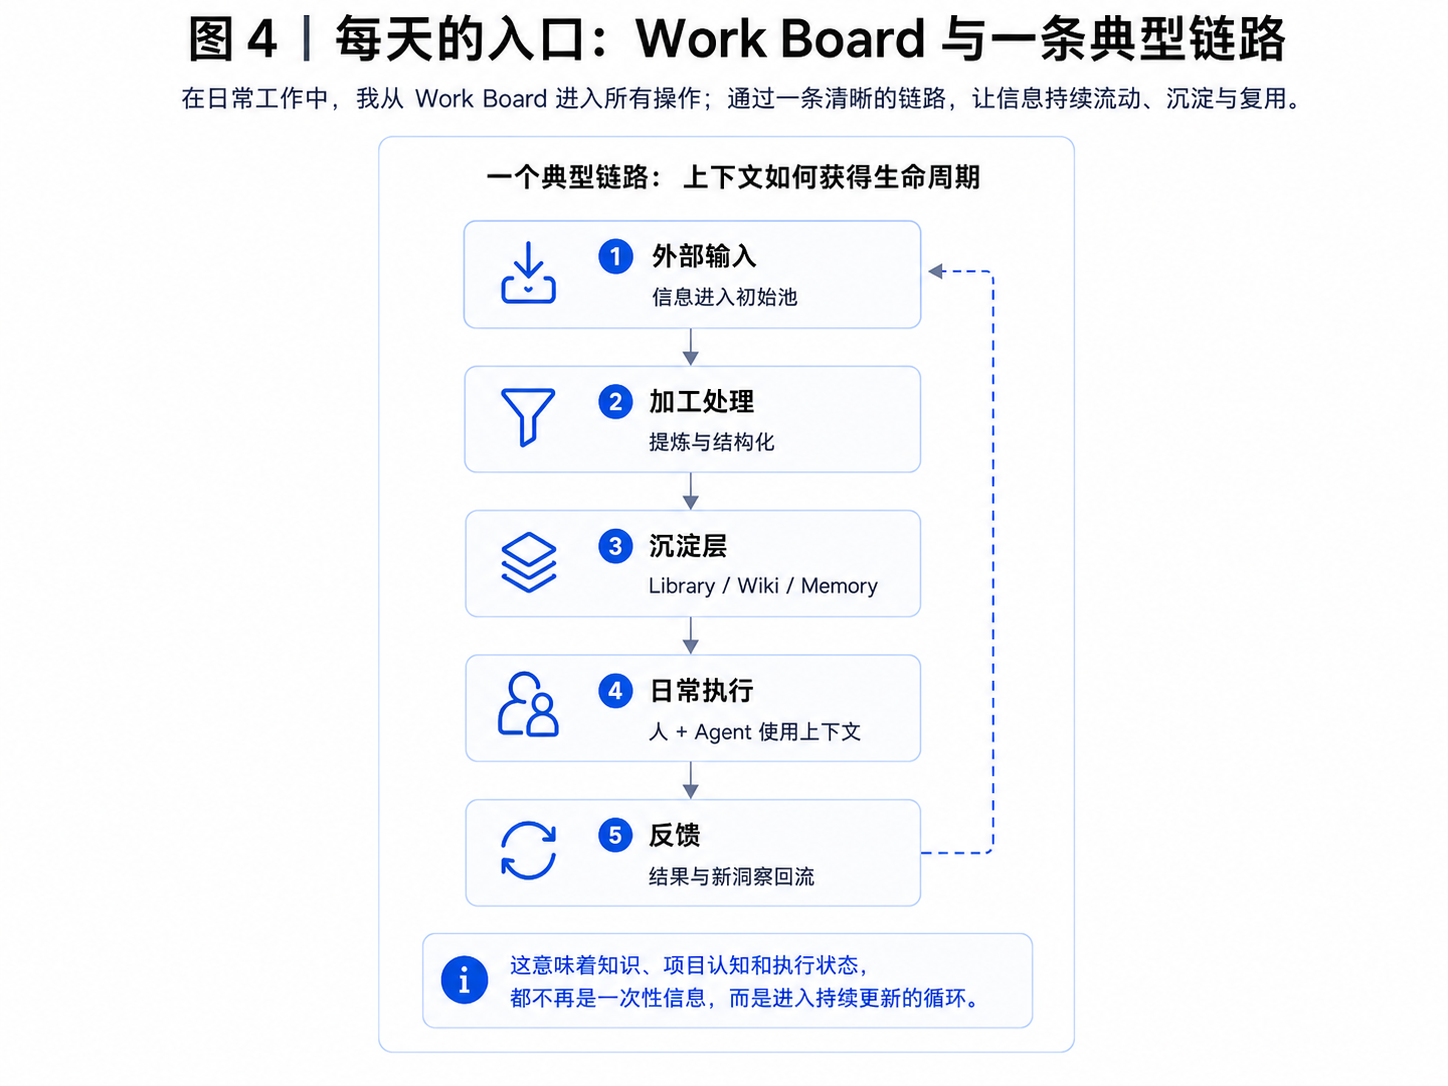
Information → Queue → Processing → Library → Memory → Agent Reuse
它解决的是知识侧的问题:什么值得继续看、如何加工、哪些结论需要长期保留。
但系统很快出现了第二类输入:Work / Project Context。
它不是外部知识,而是项目内部不断变化的状态:
- 为什么做这件事
- 已经试过什么
- 哪些方案被否掉了
- 当前判断是什么
- 还有哪些问题没解决
- 下一步准备做什么
这让我逐渐意识到,Learning 只是入口之一。真正需要持续管理的,其实有两条流:
Knowledge / Learning                Work / Projects
外部信息、研究、理解                 讨论、方案、决策、状态
            \                         /
             \                       /
              └────── Context ──────┘
系统后面的演进,基本都发生在这两个输入开始汇合之后。
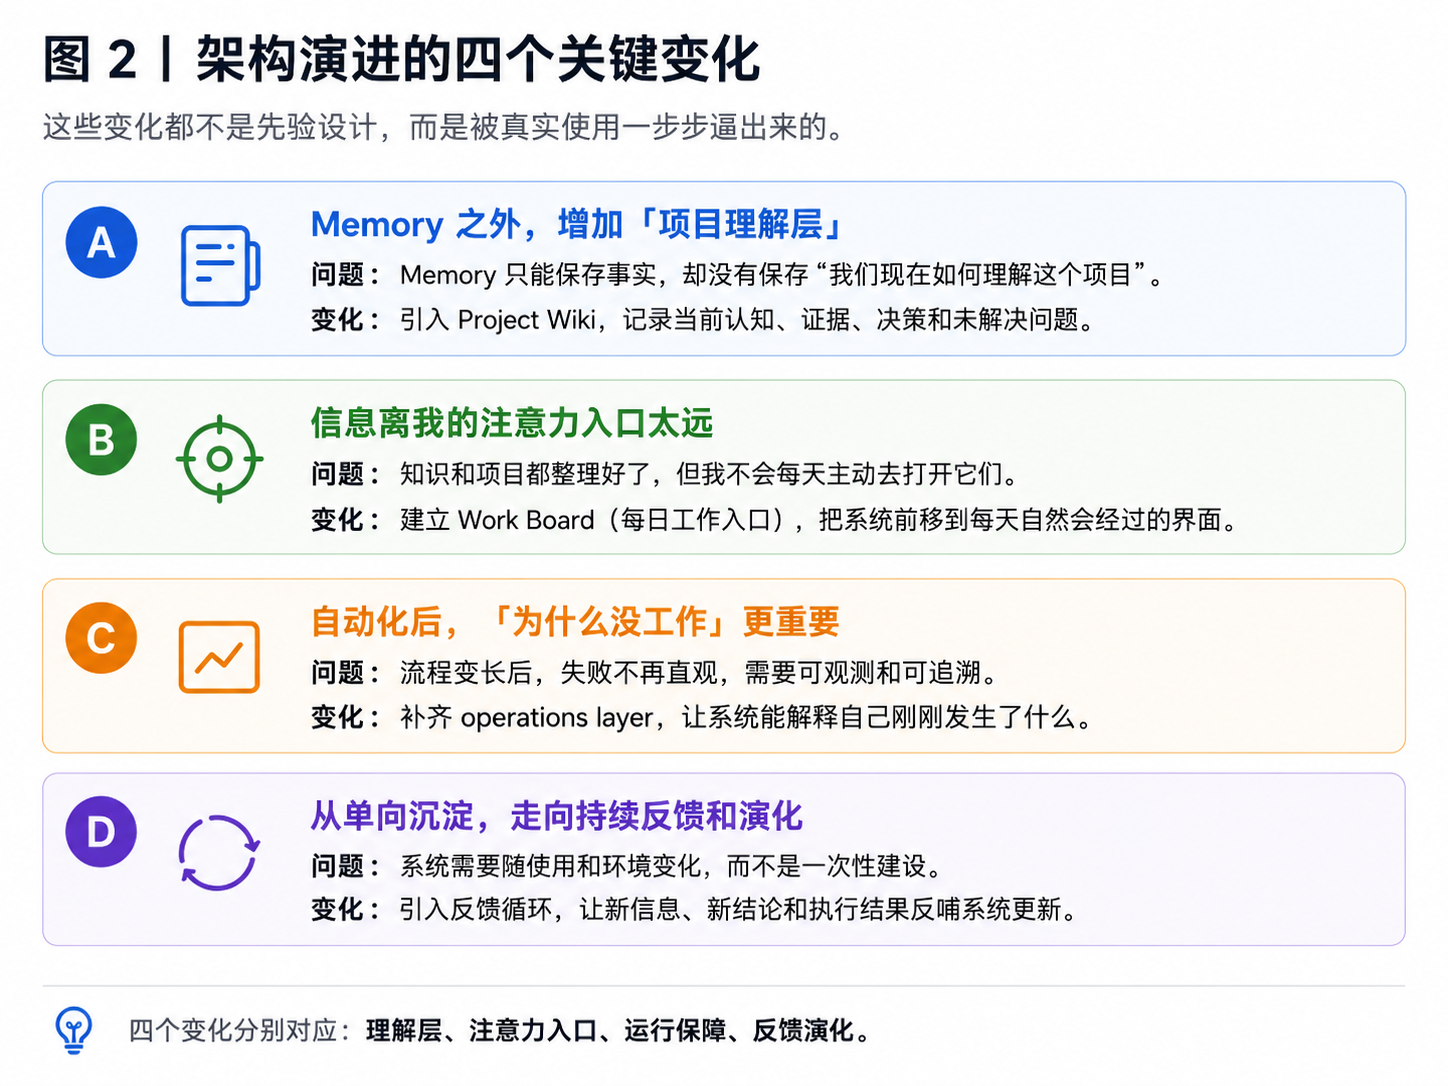
3. 第一次结构变化:资料保存下来了,但「当前项目认知」仍然会丢
最初我想象的路径很直接:
Artifact → Memory → Agent
但真实项目一旦持续几周,就会产生多轮讨论、方案版本、实验结果、被放弃的路线、已确认判断和仍未解决的问题。
这些东西都可以被保存,但保存并不等于系统知道:
于是中间增加了 Project Wiki / Project Understanding Layer。
我现在把三层理解成:
Artifact Library:发生过什么,有哪些原始材料和产出。
Project Wiki:截至现在,我们如何理解这件事。
Shared Memory:下一次 AI 执行任务时,真正需要知道什么。这里指系统为跨 Agent / 跨任务复用而维护的执行上下文层,不特指某一个模型或产品自带的 Memory 功能。
Project Wiki 也因此不再只是一个「学习笔记层」,而开始承担真实 Work Project 的长期认知状态。
4. 第二次结构变化:信息和项目都整理好了,但我仍然不会每天主动去找它们
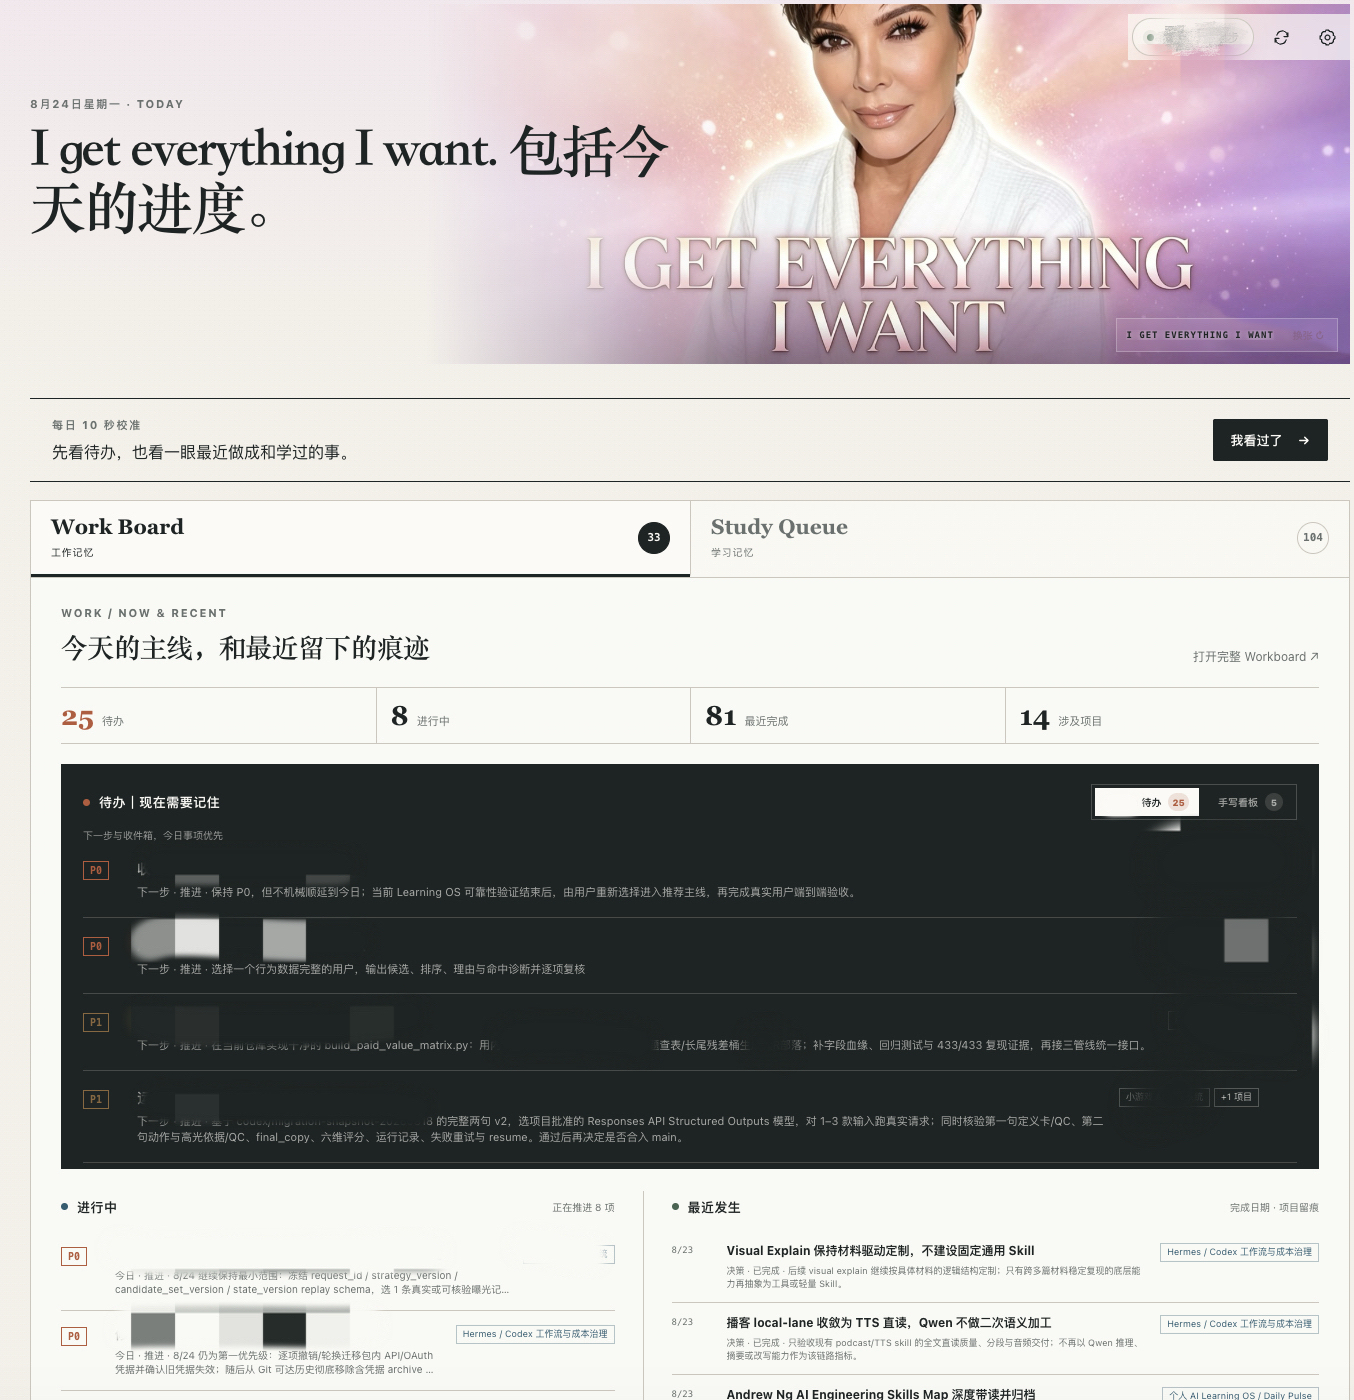
系统里开始有越来越多已经整理好的内容:学习输入、项目 Wiki、Memory、任务和自动化结果。但真正进入每天工作状态时,我发现自己还是不会主动一层层去打开它们。问题不在信息不存在,而在于:它离我的注意力入口太远。
这其实是我已经在做的 Karpathy second brain 遇到的同一道坎——它的 consume layer 越来越满,我根本看不过来。于是 Work Board 不是凭空多一个看板,而是把那层「该看什么」直接前置到了浏览器插件:每天打开浏览器第一眼就撞见,硬把自己拉回注意力流。
板上手动加入的主要是待办、加急和临时处理;项目状态则已经有一部分由 LLM 根据笔记、本地任务和近期产出自动加工、更新。少数链路也开始尝试主动补充「这件事有没有更好的解法」,但目前还远没有做到所有项目都自动维护。
我真正想要的也不是一个自动任务列表,而是让第二大脑开始从「替我存」向「替我持续理解正在发生什么」迈一步。
保存和使用之间,需要最后一公里。
比如某天早上打开新标签页时,我可能会同时看到一个昨天没收尾的项目、一条自动化链路异常,以及几条新进入的学习输入。真正有用的不是它把这些东西列出来,而是我不用再先回想「昨天做到哪了、哪个 Agent 跑过、还有什么没处理」——系统已经先把状态整理到了眼前。
Work Board:真实运行中的 Daily Interface
5. 第三次结构变化:自动化越来越多以后,「为什么没工作」开始比「能不能工作」更重要
当流程只有一两个 Prompt 时,失败通常很好理解。
但当一条链路逐渐变成:
Source → Processing → Agent → Storage → Downstream Task
某天结果没有出现,问题可能出在任意一层。
于是我开始补 Operations Layer:用 Contract 固定上下游接口,用 Trace 和 Run Registry 记录任务究竟跑到了哪里,再通过 Observability 定位异常,并用 Failure Boundary 明确失败由哪一层处理。
这些概念借自软件工程,但在这里解决的是一个很朴素的问题:
一个长期运行的个人 AI 系统,需要能够解释自己刚刚发生了什么。
举个很小的例子:当一条 Daily Route 链路某天没有产出时,我现在不再只看到「今天没生成」,而能区分是 upstream source 没有返回、processing task 失败、storage 没写入,还是 downstream 没消费到结果。
不过这层还远没有覆盖全部系统。目前真正接入 Trace / Run Registry 的,仍只是 Daily Route 等少数高频自动化链路;更多项目里的异常定位,依然需要人工回查。
就这么一层区分,让「再跑一次 Prompt」从唯一选项,变成了一个有位置的排查过程。
系统真正变复杂以后,很多问题并不来自模型能力,而来自 state、dependency、context 和 observability。
6. 两条流最终在哪里汇合
到现在,Learning 和 Work 已经不是两套独立系统,而是会真正穿过彼此。
举一个实际发生的例子:一篇论文或行业材料最初只是 Learning Input,加工后进入 Artifact Library。如果其中某个判断和正在做的游戏推荐项目有关,它就不再只是一则「学习笔记」,而会更新对应的 Project Wiki;等到下一次讨论方案时,相关判断才进入执行 Context。反过来,项目实验里得到的新结果,也可能推翻原来的知识判断,再回写 Wiki / Memory。
也就是说,两条流虽然入口不同,最终处理的是同一个问题:
到这里我才意识到,Learning 和 Work 的边界实际上已经开始消失——它们都需要生命周期:被创建、筛选、更新、降级、废弃,以及在合适的任务里再次被调用。
7. 现在的结构:它开始更像一个 Operating Layer,而不只是 Learning OS
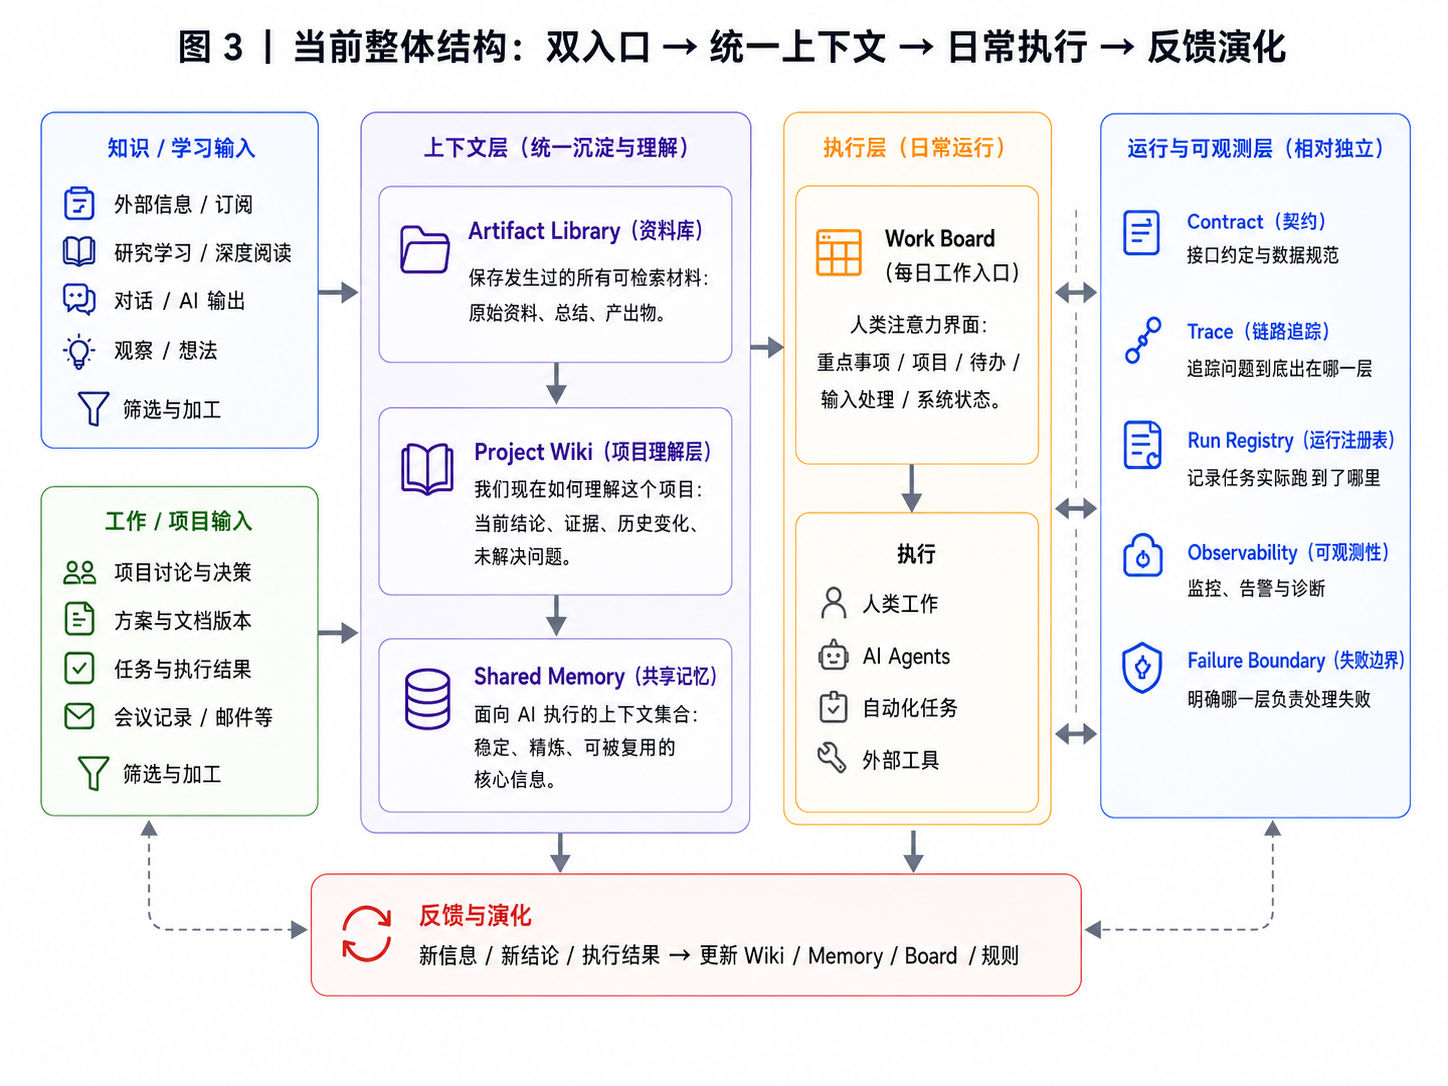
把上一节两条流的动态汇合过程静态展开,就是现在这几个彼此连接的 Layer。
最上游是两类持续变化的 Context Source:Knowledge & Learning(外部信息、研究与知识输入),以及 Work & Projects(讨论、方案、决策、实验、反馈与项目状态)。
两类输入进入同一个 Context & Understanding Layer:Artifact Library 保留「发生过什么」,Project Wiki 维护「我们现在如何理解」,Shared Memory 则服务「下一次执行真正需要知道什么」。
再往下是 Daily Operating Layer:Human + Agents + Automations。Work Board 是这一层面向人的 Attention Surface,把系统里的项目状态、重点事项和变化重新带回每天工作的入口。
贯穿整条链路的 Operations Layer——Contract · Trace · Run Registry · Observability · Failure Boundary——负责让系统在越来越自动化以后,仍然知道刚刚发生了什么、状态在哪里,以及为什么。
所以现阶段,我更愿意把它描述成一个:
而不是一个已经完成的「个人 AI 操作系统」。
8. 目前几个相对稳定的判断
这些不是我先设计出来的原则,大多是被实际使用中的问题逼出来的。
1. AI interaction 需要生命周期
关键并不是「全部记住」。
而是什么值得沉淀、沉淀到哪一层、什么时候更新,以及什么时候应该失效。
2. Artifact、Understanding 和 Memory 必须分层
原始材料、当前项目认知,以及下一次 Agent 真正需要的执行上下文,并不是同一种东西。
把它们全部塞进一个 Memory,最后往往只会得到越来越大的上下文和越来越差的信噪比。
3. Personal AI System 同时也是 Attention System
信息即使已经被正确保存,如果不能在合适的时间重新进入人的注意力,它依然很难转化成行动。
Work Board 对我真正解决的不是「展示任务」,而是把系统里已经存在的 Context 重新接回每天工作的入口。
4. Automation 越多,Observability 越重要
当系统只执行一次时,能跑出来通常就够了。
但长期运行之后,比「它能不能跑」更重要的问题逐渐变成:
它刚才到底跑到了哪里?为什么这次没完成?下一步应该重跑哪一层?
9. 目前仍然没有解决的三个问题
Memory 已经能「长」,但还不会「自己变」
这一阶段的 Memory Formation 已经部分跑通:我的笔记、任务、项目状态、Agent 跑出的结果,会经 LLM 加工沉淀成结构化 Memory,不再纯靠手动搬运。所以「记忆能不能自动生成」已经不是问题。
真正没解决的,是 Memory Evolution:当项目里某个判断变了,系统能不能自动识别 Knowledge Delta、更新已有理解、合并冲突、降级过期结论,甚至主动遗忘——而不是不断 append,也不是每次都等我人工 re-judgment。
理想回路是:
Conversation / Experiment / Artifact
  → Knowledge Delta Detection
  → Wiki Update Candidate
  → Memory Candidate
  → Review
  → Memory Evolution
这部分现在还主要靠我手动判断「什么该留、什么过期」。Memory 不应该只是 append,还需要能够修改、合并、降级和遗忘。
Context Routing 能不能可靠工作
真正的问题已经不是「有没有 Shared Memory」,而是:
不同任务,能不能拿到正确的 Context。
拿太少会失忆,拿太多会产生噪声和成本,拿错版本甚至可能比没有 Memory 更危险。
目前我的做法还比较朴素:通过 Project Wiki 的标注和任务类型规则,约定不同 Agent 应该读取哪些 Wiki 和 Memory。
少数高频任务已经能跑通,但任务和项目一多,人工规则就会开始跟不上——这也是下一步需要继续自动化的地方。
ROI 是否成立
系统越来越完整,并不天然意味着效率越来越高。
我现在还没有一套可信的量化结果。已经能感受到的正向信号,是部分高频任务减少了重复找资料和重新解释项目背景的次数;但与此同时,维护 Wiki、规则、自动化和异常处理本身也在产生新的成本。
所以下一阶段我真正想测的,不是「系统用了多少 AI」,而是几个更朴素的量:同一个项目重新进入状态需要多久、重复解释 Context 的次数是否下降、高频链路人工介入次数是否下降,以及为了维持这些收益我自己又投入了多少维护时间。
如果这些量最终没有得到正向答案,那么再漂亮的架构也只是复杂度本身。
10. 下一阶段:从「能跑」进入「能否持续成立」的验证
一个月前,我想解决的是:如何让 AI 产生的信息不丢失。现在系统已经走到:知识、项目和多个 AI 的上下文,能被持续保存、汇合与调用。
但「跑起来」和「持续成立」之间还差一段。下一阶段要验证的,就是第 9 节那三个仍未解决的问题:Memory 能不能从 Formation 走向 Evolution,Context Routing 能不能脱离越来越多的人工规则,以及整件事的 ROI 到底成不成立。
如果它们能继续跑通,我现在更想验证的,也许不是一个万能 Agent,而是:人与多个 AI 之间,是否真的需要这样一层持续维护 Context、状态和注意力的中间层。