我拆了一次 Hermes 的 Token 记录:Agent 为什么会越聊越重
一次 100 元账单引发的上下文管理复盘。因为 Claude Code 挂了,最近在尝试不同的国产模型。有一天一整天的 GLM5.2 跑下来,发现 Coding Agent 的账单明显高于预期。我把 Hermes 的会话记录和 token 数据拆开看,才发现真正的问题不在某一轮问得太多,而在长会话中,越来越大的历史上下文正在被持续复用。
有些意外。因为我并不是完全没有上下文管理意识:平时会看对话里的上下文占用进度,Claude Code 也用得比较多。它通常会在会话变长后自动压缩,所以我一直没有特别担心长对话的 token 消耗。
直到我把 Hermes 的会话记录和 token 数据拆开看,才发现真正的问题不在某一轮问得太多,而在长会话中,越来越大的历史上下文正在被持续复用。
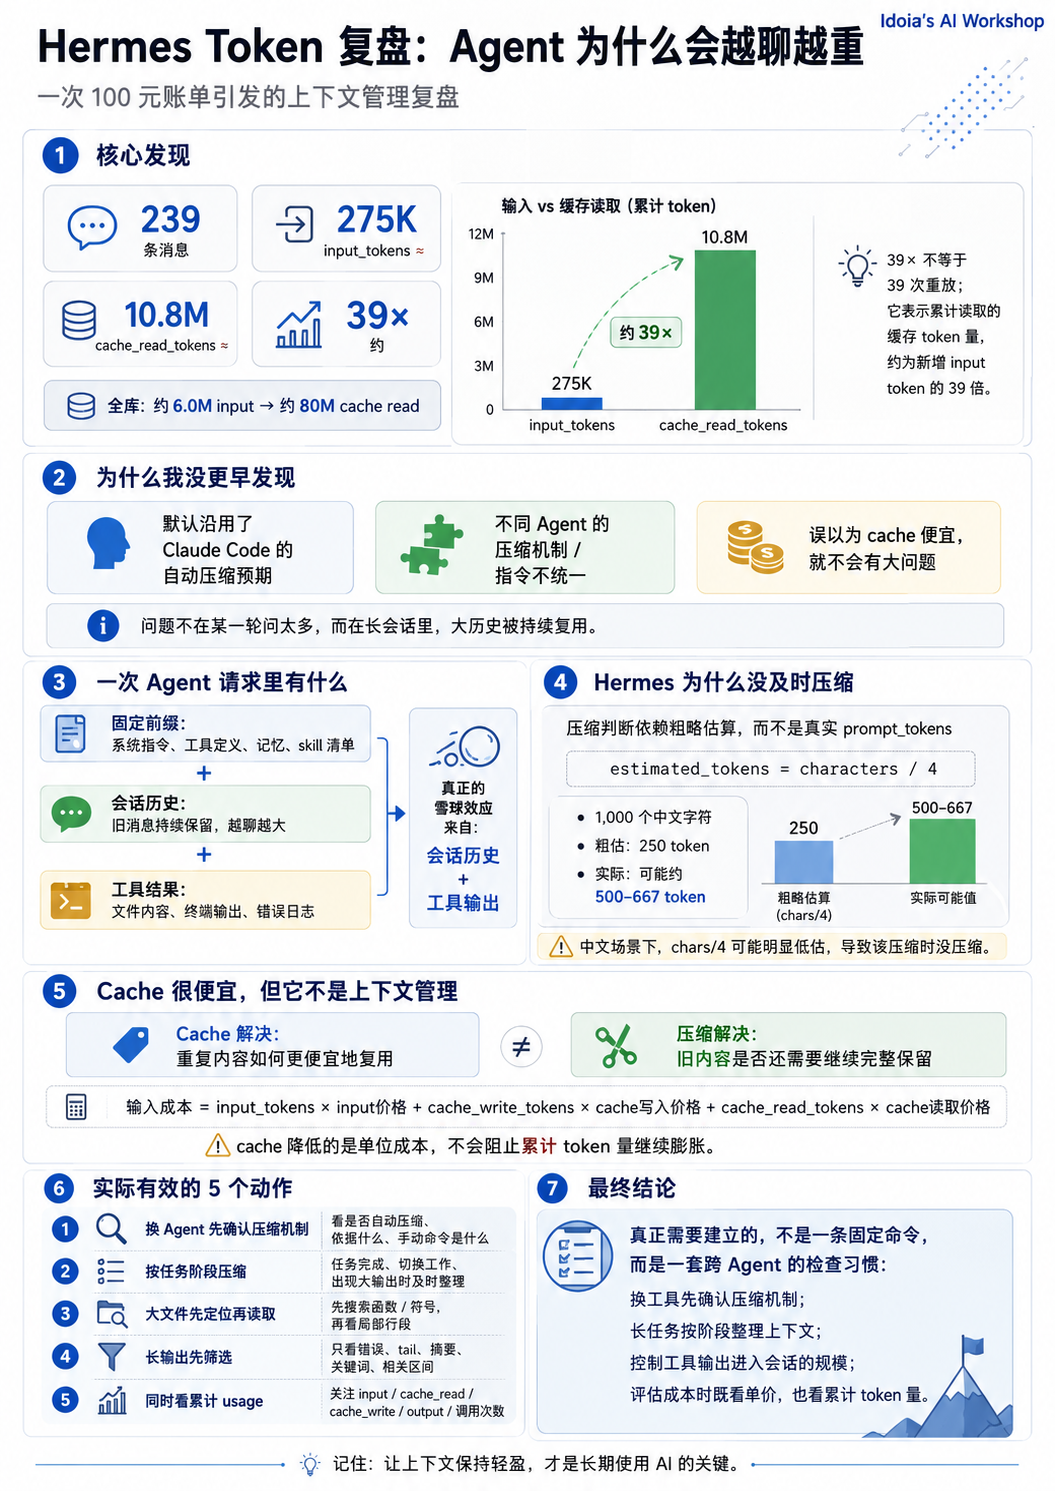
其中一个包含 239 条消息的会话里:
- 数据库记录的
input_tokens约为 275K; cache_read_tokens达到 10.8M;- 后者是前者的约 39 倍。
全库也有类似结构:约 6.0M input,对应约 80M cache read。
这个 39 倍不等于"同一段上下文刚好重放了 39 次",也不能直接换算成 39 倍费用。它表示的是:累计读取的缓存 token 量,已经达到新增 input token 量的约 39 倍。
换句话说,每轮真正新增的内容可能不多,但它背后携带的历史已经很大。
一、为什么我没有更早发现
复盘下来,有三个原因叠加在一起。
第一个原因,是我已经在 Claude Code 里形成了一套使用习惯。我平时会留意上下文占用情况,而 Claude Code 通常会在会话变长后自动压缩。久而久之,就形成了一个默认预期:只要关注上下文进度,接近上限时 Agent 会主动处理,不太需要我频繁干预。然后,这个预期就被自然地带到了其他 Agent 上。
第二个原因,是不同 Agent 的上下文管理方式并不统一。Claude Code、Codex 和 Hermes 的上下文管理机制并不完全相同。有的更依赖自动压缩,有的依赖内部阈值,有的则更需要用户主动触发。它们的压缩命令和交互方式也不统一。当我在多个 CLI 和客户端之间切换时,很难形成稳定的肌肉记忆:在哪个工具里、到什么阶段、应该执行哪条压缩命令。因此即使知道长会话需要管理,也很容易忘记及时手动处理。
第三个原因,是我对 prompt cache 有一层心理兜底。Cache 的读取价格通常比全新 input 低很多。因此我原本认为,即使历史上下文被重复带入,只要大部分能够命中缓存,实际成本应该不会太夸张。
这个判断不能算错,但它忽略了累计规模。Cache 降低的是单位读取成本。如果一个越来越大的上下文被持续复用,即使每次都打折,累计 token 量仍然可能很大。
大文件和长段工具输出又进一步放大了这个问题。一次读取几百行文件,成本不一定只发生在第一次读取。只要内容继续留在会话历史里,后续请求就可能继续携带它,并计入缓存读取。
直到看到那天的账单,我才意识到:需要检查的不是"今天多问了多少句话",而是每一轮请求背后究竟已经带上了多少旧内容。
二、一次 Agent 请求里到底有什么
一轮 Agent 请求通常包含三类输入。
第一类是相对固定的前缀,例如:
- 系统指令和执行规则;
- 工具定义;
- 用户记忆和项目规则;
- 可用 skill 的清单与描述。
这些内容未必会持续增长,但会构成每轮请求的基础体积。
第二类是会话历史。只要旧消息还被保留,它们就可能继续出现在后续请求中。会话越长,这部分通常越大。
第三类是工具结果。文件内容、代码搜索结果、终端输出和错误日志都会进入上下文。一次读取几百行文件,可能比此前多轮自然语言交流加起来还大。
真正形成雪球的,主要是后两类:不断增长的会话历史,以及缺少控制的工具输出。
Skill 也需要区分来看。Skill 清单可能属于固定前缀;某个 skill 的详细说明、reference 和 template 是否持续保留,则取决于具体 Agent 的加载机制。不能简单理解成"安装一个 skill,所有内容就永久叠加一次"。
三、这次 Hermes 的自动压缩为什么没有及时发生
长会话并不必然无限增长。正常情况下,Agent 可以在上下文接近阈值时压缩旧历史,将早期内容总结成更短的状态。
这次 Hermes 的问题出在压缩依据上。在我检查的版本中,主预检路径传给压缩判断的仍然是基于字符数生成的粗略 token 估算,而不是 provider 返回的真实 prompt_tokens。真实 token 的追踪逻辑在其他位置已经存在,但没有正确接入当前生效的预检路径。
粗略估算使用了类似这样的换算:
estimated_tokens = characters / 4这种公式只能作为近似,而且在中文环境下偏差会比较明显。例如 1,000 个中文字符,按照 chars/4 只会被估算成 250 token。实际数量取决于具体模型及 tokenizer;在不少中文场景中,真实 token 数可能明显高于这一估算,甚至接近其两倍或更多。压缩判断接收到的值因此可能只有实际值的一半,甚至更低。
当系统依据这个偏低的值判断时,真实上下文已经很大,压缩阈值却可能仍然显示"尚未达到"。旧历史继续保留,后续请求再继续携带它。
这是此次 Hermes 版本中能够落实到代码路径的问题。它不能证明所有 Coding Agent 都存在相同缺陷,但暴露了一个通用风险:
四、Cache 很便宜,但它不是上下文管理
Prompt cache 的作用,是让重复前缀以较低的价格和较低的预填充成本被复用。它当然有价值,但不能替代压缩。
不同 provider 和模型的 cache read、cache write 定价并不相同。真实费用需要按照对应模型的价格计算:
输入成本
= input_tokens × input价格
+ cache_write_tokens × cache写入价格
+ cache_read_tokens × cache读取价格
Hermes 数据库中的 estimated_cost_usd=0,在这次环境里是因为没有匹配到对应模型的定价信息,并不代表调用没有成本。
此外,缓存内容仍然属于模型的上下文。即使缓存降低了重复前缀的处理成本,它仍会占用 context window;长上下文也仍可能影响可用窗口、延迟和后续推理。
因此,cache 和压缩解决的是两个不同的问题:
- Cache 解决的是:重复内容如何更便宜地复用;
- 压缩解决的是:这些旧内容是否还有必要继续完整保留。
我的误判就在于:因为前者足够便宜,低估了后者失控后的累计影响。
五、实际使用中,哪些操作有效
1. 换 Agent 时,先确认它怎么管理上下文
不能把 Claude Code 里的使用预期直接迁移到 Codex、Hermes 或其他 Agent。至少需要确认三件事:
- 它是否会自动压缩;
- 自动压缩依据的是真实 token,还是粗略估算;
- 手动压缩的命令和效果是什么。
在我当前检查的 Hermes 版本中,可以使用 /compress 手动触发压缩。
2. 按任务边界压缩,而不是死记消息数量
"每 60 条消息压缩一次"只能作为粗略提醒。60 条纯文字对话和 60 条大文件读取,体积可能相差几十倍。更合适的时机是:
- 一个任务阶段已经完成;
- 准备切换到另一项工作;
- 刚刚产生过大段文件或终端输出;
- 早期过程已经不需要逐字保留。
压缩本身是有损的。如果接下来的任务与当前工作关系不大,可以先生成一份交接摘要,记录关键结论、文件、约束和未完成项,然后开启新会话。
3. 大文件先定位,再读取
读取文件前,可以先使用 rg、代码搜索或符号定位找到相关函数,再读取具体行段。关键不是"不能读大文件",而是不要在尚未定位问题时,把整份文件反复放进上下文。
4. 长命令输出需要筛选,而不只是重定向
将完整结果写入文件,本身不会自动节省 token。如果随后又把整个文件读入上下文,成本没有本质区别。真正有效的是:
- 只看错误行;
- 使用
tail检查末尾结果; - 提取统计摘要;
- 根据关键词定位;
- 只读取相关区间。
5. 不只看上下文进度,也要看累计使用量
上下文进度告诉你当前窗口是否接近上限,但不一定能反映已经发生的累计 cache read 和实际费用。如果 Agent 或 provider 提供 usage 数据,至少可以同时关注:
input_tokenscache_read_tokenscache_write_tokensoutput_tokens- API 调用次数
- 单次请求的 prompt 变化
cache_read / input 不能直接解释成重放次数,但可以作为长会话是否正在反复携带大量旧内容的诊断信号。
六、最后的结论
这次账单异常,不是因为我完全没有上下文管理意识。更准确地说,是三个原本合理的判断叠加在了一起:
- Claude Code 的自动压缩让我形成了默认预期;
- 多个 Agent 的压缩机制和指令不统一,打断了手动管理习惯;
- Cache 的低单价让我低估了累计读取量,以及大文件进入长会话后的持续影响。
Agent 越聊越重并不一定意味着实现出了 bug,也不一定只是用户使用不当。更常见的情况是:自动压缩、缓存和个人使用习惯之间存在一段没有被注意到的空隙。
好在,这次让我意识到问题的,只是一张 100 元的账单,而不是一次真正失控的长期任务。
谨以此文 mark 这一课,也把它分享出来,希望能帮助更多像我一样的"文科生"提前避坑。